


上海财经大学郭峰教授做客数字金融团队学术活动
2025年6月30日上午,北京工商大学经济学院数字金融团队在阜成路校区综合楼1215A会议室成功举办了第3期校外专家学术交流活动。本次活动由上海财经大学郭峰教授主讲,题目为“人工智能数字经济时代因果识别研究范式变革”。讲座由北京工商大学数字金融研究中心主任、数字金融团队负责人张正平教授主持,数字金融团队赵峰、李波、郭冠楠、程悦等教师、经济学院部分教师及在读博士生、硕士生代表参加了本次活动。
正式报告前,张正平教授简要介绍了郭峰教授的学术成就,并对郭峰教授莅临北京工商大学表示热烈欢迎。
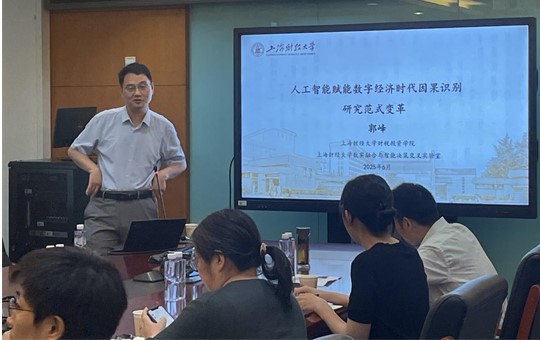
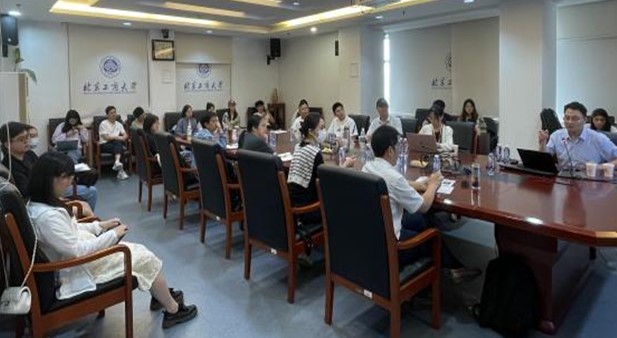
郭峰教授首先从“数字经济研究选题反思”为切入点,系统阐述了以下核心内容:一是就数字经济研究现状进行分析,指出数字经济研究已广泛渗透消费、企业管理、经济发展等各个领域;二是数字经济时代经济社会关系的新变化,强调数字经济深刻改变、放大、弱化甚至逆转了人们的行为模式与社会经济关系;三是大数据研究的机遇,指出未来可利用数字经济产生的海量、多源数据(如音视频、邮件、文档、图片等)研究上述新变化的潜力,并指出这亟需更新研究工具与研究范式。此外,郭峰教授进一步指出,尽管当前研究覆盖面广,仍存在值得关注的深层问题,如机制挖掘不足、非结构化数据处理瓶颈等方面。因此,未来如何从海量碎片化信息中提炼出具有普遍解释力的规律,仍是方法论上的关键挑战。
其次,郭峰教授详细阐释了机器学习的基本原理及其与传统计量经济学的核心区别。他指出,机器学习的核心关注点是预测,这与计量经济学聚焦于因果识别的目标截然不同。郭峰教授强调,需从计量经济学视角审视机器学习,不仅要认识到机器学习强大的预测能力可以补充甚至增强经济学对因果关系的探索,同时还须认识到机器学习在模型可解释性、经济机制推断以及处理内生性等核心计量问题上的局限。此外,他还进一步认为,机器学习擅长挖掘复杂模式与实现高精度预测,却难以明确识别变量间的因果关系。计量经济学则专注于通过严谨的研究设计(如工具变量法、随机对照试验、断点回归等)控制混淆因素、处理内生性,以识别干预或变化的真实因果效应。
再次,郭峰教授分析了“机器学习对因果识别的助力与冲击”,包括:(1)能用机器学习做什么,尤其是在经管学科中的应用(预测、数据生成、因果识别等),例如提升政策效应预测准确性、生成高质量合成控制组、辅助发现潜在工具变量等;(2)要清晰认识机器学习方法和因果识别之间的差异,主要体现在机器学习通常侧重于预测准确性和模式识别,而因果识别则更强调理解变量间的作用机制并需要严格的识别假设(如外生性、无混淆等),机器学习模型(尤其是深度学习)的可解释性不足也增加了因果推断的难度;(3)在识别与控制混淆因素方面,机器学习可以通过高维变量选择、降维技术(如表征学习)或灵活的建模方式(如基于树的方法)来更有效地挖掘和处理大量潜在的混淆变量,从而提高因果效应估计的准确性;(4)针对双重差分法的创新使用可以体现在将机器学习融入DID框架以处理非平行趋势问题、识别动态处理效应或更灵活地构建对照组,如通过机器学习匹配或加权提高模型的精准度。
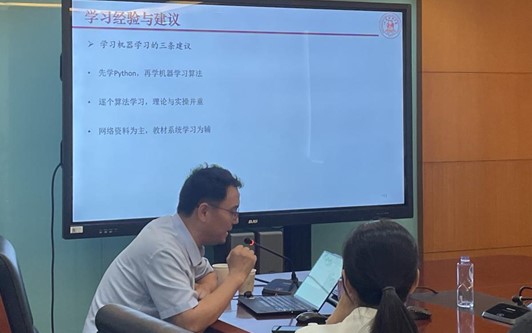
最后,郭峰教授结合自身研究经验,就如何有效运用机器学习提出了几点建议。其一,要掌握Python编程语言,这是应用机器学习的主流工具和基石,为后续算法学习与实践打下坚实基础。其二,在学习算法时,应逐个深入理解,做到理论学习(深入理解数学原理与模型机制)与动手实践(动手复现经典模型、调试代码、分析结果)并重,避免浅尝辄止。其三,学习资源以高质量的网络资料(如权威技术博客、开源项目文档、MOOC平台课程、前沿论文)为主,充分利用其时效性强、案例丰富的优势;同时辅以经典教材进行系统学习,确保知识体系的完整性与逻辑性,实现点面结合。
报告结束后,参会老师和学生结合报告内容,将自己研究遇到的问题和报告中的困惑向郭峰教授请教,郭峰教授一一进行了解答。
对于这次学术交流活动,参与的师生们纷纷表示收获颇丰,对数字经济时代的学术研究和机器学习方法的逻辑和应用方向有了更加清晰的认识和理解,为将来的科研探索创提供造了新的思路和方向。张正平教授则强调,后续数字金融团队将持续举办类似的学术交流活动,邀请国内外知名专家来讲座,努力提升团队师生的研究能力。
作者:金融系
编辑:孙嘉琳
审核:许敬轩
审定:詹新宇